Професор Джефри Хинтън обеща, че в близкото десетилетие компютрите ще се научат да мислят като хора, в това число и да флиртуват. За това ще им помогнат нов клас алгоритми, които Хинтън разработва за компанията Google.
Както разказа професорът, принципа на работа на неговия алгоритъм се основава на това, че на всяка дума се приписва набор от цифри (същия този вектор), който определя неговото положение в теоретичното „смислово пространство“ или облак. Предложението може да се разглежда като съединителна линия между тези думи, и на свой ред също да доведе до набор от цифри или „вектор на мисълта“.
Основната сложност е в това да се разбере какви цифри са приписани на всяка дума от езика. На този етап учените се обръщат към така наречения метод „на дълбоко обучение“. Позициите на думите в смисловия облак се разпределят по случаен образ, а след това изкуственият интелект започва да тренира, като му се предлага за обработка масив от данни.
В частност, алгоритъма бива разработван, за да подобри програмите за машинен превод (подобни на Google Translate). Сега такива програми превеждат отделните думи от речника, а също разглеждат по-рано преведени документи, за да намерят общоупотребителни аналози на тези или онези фрази. Макар, че получения текст често да позволя да се улови основния смисъл на оригинала, има случаи, когато резултата изглежда като катастрофа от думи или противоречи на правилата на граматиката.

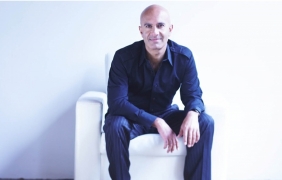
Снимка: Проф. Джефри Хинтън пред централата на Google
Векторите, както обясни Хинтън, позволяват по-точно да се определи първоначалния смисъл на казаното. В ролята на масив от данни в този случай влиза набор от преведени документи. Първо превода изглежда като глупост, но обратната връзка позволява на машината да определи къде е била допусната грешка. Въз основа на получената информация изкуственият интелект коригира положението на всяка дума, докато неговия смислов облак не започне да съвпада с използвания от хората.
„Ако вземете вектор, който обозначава Париж, махате вектора, който съответства на Франция, и го заменяте с Италия, и така Париж става Рим“, поясни Хинтън. „Доста забележително, нали?“.
По мнение на професора, компютрите трудно ще се научат да разпознават иронията, но да се създаде отговаряща на флирт програма ще е доста по-лесно. „Вероятно, в началото тя ще се обръща доста праволинейно, без намеци“, каза той.
Хинтън е част от екипа на Google от 2013 година. През 80-те години на миналия век се е занимавал с изискванията в областта на метода на „дълбоко обучение“. Под „дълбоко обучение“ обичайно се разбира разновидност на машинно обучение, предвиждащо използването на невронни мрежи на много нива. Невронните мрежи са математически модели, симулиращи процеса на обучение на човека, а тяхното достойнство е способността да възприемат неподредена информация.


Този уебсайт ползва “бисквитки”, за да Ви предостави повече функционалност. Ползвайки го, вие се съгласявате с използването на бисквитки.